Рукописное задание по фото: как повысить точность
Распознавание рукописного задания по фото: почему сложнее печатного — вопрос, с которым сталкиваются и пользователи, и разработчики OCR-систем. Если печатный текст алгоритмы читают почти безошибочно, то почерк с его вариативностью и условия съёмки превращает задачу в настоящий технический вызов. Разберём, как это работает и почему даже современные нейросети до сих пор ошибаются.
Как устроено распознавание текста на фото
В основе распознавания лежит технология OCR (Optical Character Recognition) — система, которая превращает изображение с текстом в набор символов, понятных компьютеру. На практике это не «чтение» в человеческом смысле, а цепочка вычислительных этапов, где изображение постепенно очищается и анализируется.
Процесс обычно разбивается на несколько шагов:
- Предобработка изображения — повышение контраста, удаление шума, выравнивание перспективы.
- Сегментация — выделение строк, слов и отдельных символов.
- Распознавание — сопоставление символов с известными шаблонами или предсказание с помощью нейросети.
- Постобработка — исправление ошибок с учётом языка и контекста.
Современные системы всё чаще используют нейронные сети, которые не просто сравнивают символы с шаблонами, а учатся на больших массивах данных. Это позволяет учитывать форму букв, их взаимное расположение и даже вероятные слова.
По данным исследований в области компьютерного зрения, точность распознавания печатного текста в контролируемых условиях может превышать 98%, что делает OCR одной из самых зрелых технологий ИИ.
Однако важно понимать: алгоритм работает с пикселями, а не со «смыслом». Он анализирует контраст, формы и границы, поэтому любые отклонения — от освещения до искажений — напрямую влияют на результат.
Почему этап предобработки так важен
Даже качественная нейросеть может ошибаться, если изображение размыто, наклонено или содержит тени. Предобработка снижает эти искажения и делает данные более «читаемыми» для алгоритма.Почему печатный текст — простая задача для алгоритмов
Для алгоритмов печатный текст — это предсказуемая и хорошо структурированная система. Буквы имеют фиксированную форму, одинаковые пропорции и чёткие границы, а сами строки располагаются ровно и последовательно. Это резко снижает неопределённость при анализе изображения.
С точки зрения OCR, печатный текст удобен по нескольким причинам:
- Стандартизированные шрифты — ограниченное число вариантов начертания символов.
- Чёткие границы букв — символы не сливаются друг с другом.
- Ровные строки — текст легко сегментируется на строки и слова.
- Повторяемость — одинаковые буквы выглядят одинаково в пределах документа.
Это позволяет использовать даже сравнительно простые методы распознавания, включая шаблонное сопоставление — когда символ сравнивается с эталонными образцами.
- Шаблонное сопоставление
- Метод, при котором изображение символа сравнивается с заранее заданными шаблонами для поиска наиболее похожего варианта.
В реальных системах распознавания печатного текста точность может достигать 95–99% даже на массовых документах, таких как книги или сканы.
Именно поэтому для алгоритма печатный текст выглядит как упорядоченный набор знакомых форм, где каждая буква легко отделяется от соседней и распознаётся без сложных предположений.
Что делает почерк источником хаоса для нейросети
В отличие от печатного текста, рукописный текст не подчиняется строгим правилам формы и структуры. Для нейросети это означает резкий рост неопределённости: одна и та же буква может выглядеть по-разному не только у разных людей, но и у одного человека в пределах одной страницы.
Главная проблема — отсутствие стабильности. Алгоритм больше не может опираться на фиксированные шаблоны и вынужден учитывать множество вариаций:
- Нестабильная форма букв — символы искажаются, упрощаются или усложняются.
- Изменчивый наклон и размер — строки «плывут», буквы выходят за границы.
- Нарушенная структура строки — слова могут идти неравномерно, с разными интервалами.
- Шумы — исправления, зачеркивания, пятна и тени.
С технической точки зрения это усложняет этап сегментации — выделения отдельных символов. Если в печатном тексте границы букв очевидны, то в почерке они часто размыты или вовсе отсутствуют.
- Сегментация
- Этап обработки изображения, при котором текст разбивается на строки, слова и отдельные символы для последующего распознавания.
Исследования показывают, что точность распознавания рукописного текста может снижаться до 70–85% даже при использовании современных нейросетей, особенно на неаккуратных или смешанных почерках.
В результате нейросеть работает не с «готовыми буквами», а с неоднозначными визуальными сигналами, где каждое решение — это вероятностная гипотеза, а не точное совпадение.
Почему человеку проще читать почерк
Человек использует контекст, опыт и знание языка, чтобы «достраивать» непонятные буквы. Нейросеть тоже пытается учитывать контекст, но её возможности в этом пока ограничены по сравнению с человеческим восприятием.Индивидуальность почерка и отсутствие единого шаблона букв
Ключевая сложность распознавания — в том, что почерк каждого человека уникален. В отличие от печатных шрифтов, где форма букв стандартизирована, рукописные символы могут сильно отличаться по форме, наклону и степени разборчивости.
Для алгоритма это означает отсутствие «эталона», с которым можно было бы сравнить символ. Одна и та же буква может выглядеть как несколько разных вариантов, а разные буквы — наоборот, становиться визуально похожими.
- Вариативность написания — буква «а» может быть округлой, угловатой или почти неразличимой.
- Сокращения и упрощения — элементы букв опускаются ради скорости письма.
- Смешение стилей — печатные и прописные формы используются одновременно.
- Индивидуальные привычки — уникальные соединения и штрихи, понятные только автору.
С точки зрения ИИ, это требует перехода от простого сопоставления к вероятностному распознаванию, где система оценивает, какой символ наиболее вероятен в данном контексте.
- Вероятностная модель
- Подход, при котором алгоритм выбирает наиболее вероятный вариант распознавания на основе статистики и контекста, а не точного совпадения формы.
По оценкам исследователей, разнообразие почерков настолько велико, что для устойчивого распознавания требуется обучение на сотнях тысяч и миллионах примеров.
В результате нейросеть вынуждена учитывать не только форму отдельной буквы, но и контекст слова целиком, что делает задачу значительно сложнее по сравнению с печатным текстом.
Почему одинаковый почерк тоже «плывёт»
Даже у одного человека форма букв меняется в зависимости от скорости письма, усталости или инструмента (ручка, карандаш). Это добавляет вариативности даже внутри одного текста.
Слитное написание слов и неоднозначные границы символов
Даже если форма отдельных букв уже распознана, возникает следующая проблема — сегментация текста, то есть определение, где заканчивается один символ и начинается другой. В печатном тексте эта задача решается почти автоматически: буквы отделены пробелами и имеют стабильные интервалы. В рукописном же письме границы часто размыты или вовсе отсутствуют.
Особенно это заметно при слитном написании: буквы соединяются штрихами, перекрываются или «перетекают» друг в друга. Для человека это не проблема — мозг достраивает образ слова целиком. Но алгоритм видит лишь непрерывный набор линий, где невозможно однозначно разрезать текст на отдельные символы.
Типичные сложности сегментации включают:
- слияние соседних букв в один графический контур;
- неоднозначные разрывы (например, где «и» может выглядеть как часть «ш»);
- разная ширина символов внутри одного слова;
- отсутствие чётких пробелов между словами.
С точки зрения алгоритма это означает, что сначала нужно «угадать» границы символов, а уже потом — распознать сами буквы. Если ошибка возникает на первом этапе, дальнейшее распознавание становится цепочкой искажений.
В задачах распознавания рукописного текста ошибка сегментации считается одной из главных причин снижения точности — по данным исследований, она может влиять на итоговый результат сильнее, чем качество классификатора символов.
Современные нейросети пытаются обойти эту проблему, используя сквозное распознавание последовательностей — подход, при котором модель анализирует слово целиком, не разбивая его заранее на буквы.
- Сквозное распознавание
- Метод, при котором нейросеть обрабатывает изображение как последовательность и предсказывает сразу строку текста, минуя этап явной сегментации.
Однако даже такие модели сталкиваются с неоднозначностями: одно и то же «слитное» изображение может соответствовать разным словам, особенно в школьных тетрадях с быстрым почерком.
Почему человек справляется лучше
Человек использует контекст: даже если буквы слиты, смысл слова и грамматика языка помогают восстановить правильное чтение. Нейросети только учатся учитывать такой контекст, и делают это пока менее надёжно.
Влияние качества фото и условий съёмки на точность
Даже идеально написанный текст может быть распознан с ошибками, если исходное изображение содержит дефекты. Для алгоритмов важна не только форма букв, но и качество входных данных: любое искажение на фото напрямую влияет на итоговую точность.
В отличие от человека, который способен «достроить» недостающие детали, система OCR и нейросети работают с тем, что «видят». Если изображение размыто или засвечено, часть информации фактически теряется, и восстановить её становится невозможно.
Ключевые факторы, влияющие на результат:
- Разрешение: низкое качество изображения приводит к потере мелких деталей букв;
- Освещение: тени, блики и неравномерный свет искажают контуры;
- Размытие: движение камеры или плохой фокус «размывают» штрихи;
- Перспектива: съёмка под углом деформирует текстовые строки;
- Фон: клетка тетради, линии или текст с обратной стороны создают шум.
Особенно критична проблема шумов изображения — случайных искажений, которые алгоритм может принять за часть символа.
- Шумы изображения
- Нежелательные визуальные артефакты (зернистость, пятна, тени), которые мешают корректному анализу изображения.
На практике это приводит к тому, что один и тот же текст может распознаваться по-разному в зависимости от условий съёмки. Даже небольшое изменение освещения или угла может кардинально изменить результат.
По данным исследований в области OCR, снижение качества изображения (например, добавление шума или размытия) может увеличивать количество ошибок распознавания на десятки процентов, особенно для рукописного текста.
Современные модели пытаются компенсировать эти искажения с помощью предварительной обработки изображений: выравнивания, повышения контрастности и удаления шума. Однако такие методы работают эффективно только в пределах разумных искажений — при сильных дефектах качество распознавания резко падает.
Почему фото с телефона часто хуже, чем кажется
Человеческий глаз адаптируется к освещению и автоматически «фильтрует» шум. Камера же фиксирует всё буквально: блики от лампы, тени от руки, изгиб страницы. Поэтому изображение, которое выглядит читаемым для человека, может быть сложным для алгоритма.
Особенности школьных и учебных рукописных заданий
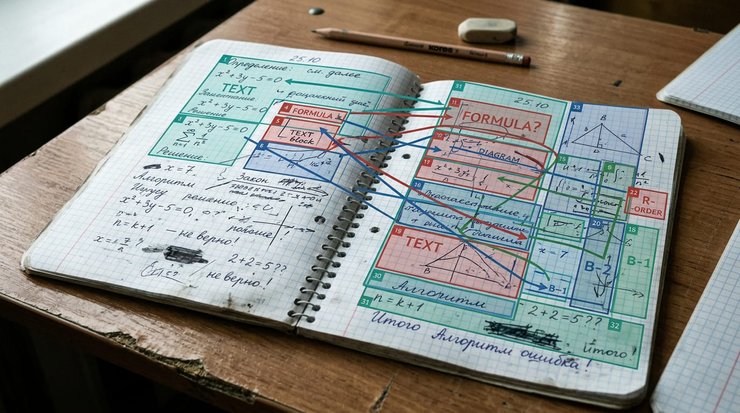
Учебные рукописные задания представляют собой особый тип данных, который значительно отличается от «чистого» рукописного текста. Здесь сочетаются разные форматы записи: текст, формулы, подписи, схемы и пометки. Для алгоритма это не просто строка символов, а сложная визуальная структура, где элементы могут располагаться в произвольном порядке.
Дополнительную сложность создаёт то, что такие задания часто пишутся быстро, «на черновик», с исправлениями и сокращениями. В одном и том же фрагменте могут встречаться аккуратные буквы и почти неразборчивые штрихи, что делает распознавание неоднородным и нестабильным.
На практике это особенно заметно, когда пользователи пытаются получить решение задания по снимку: даже качественное фото не гарантирует корректный результат, если исходный текст содержит много правок или нестандартных обозначений.
К типичным особенностям школьных заданий относятся:
- наличие зачёркиваний, исправлений и надписей поверх текста;
- смешение печатных и рукописных символов;
- использование сокращений и условных обозначений;
- разные типы контента: текст, цифры, формулы, рисунки;
- нестабильная структура строк и отступов.
Отдельную проблему создаёт многоуровневая разметка, когда текст располагается не в одну линию, а в виде столбцов, списков или сносок.
- Многоуровневая разметка
- Организация текста, при которой элементы расположены на разных уровнях или в разных зонах страницы, а не последовательно в строку.
Алгоритму приходится не только распознавать символы, но и понимать, в каком порядке их читать. Ошибка на этом этапе может полностью изменить смысл задания.
Исследования показывают, что гибридные документы (текст + формулы + пометки) распознаются значительно хуже, чем однородный текст: точность может снижаться на 20–40% в зависимости от сложности структуры.
Почему школьные тетради — сложный случай
Линии и клетка в тетрадях создают дополнительный «шум» для алгоритма. Они могут восприниматься как часть символов или мешать выделению текста, особенно если совпадают с направлением штрихов.
Как современные нейросети всё же учатся читать почерк
Несмотря на все сложности рукописного текста, современные системы распознавания делают заметный прогресс благодаря использованию глубоких нейронных сетей. В отличие от классического OCR, который работает по жёстким правилам, нейросети обучаются на огромных наборах данных и учатся находить закономерности даже в хаотичных и неоднородных изображениях.
Ключевой сдвиг произошёл с переходом к сквозным моделям распознавания, которые анализируют изображение целиком, не разбивая его заранее на отдельные символы. Это позволяет учитывать контекст: модель «понимает» слово как последовательность, а не как набор независимых букв.
- Сквозная модель
- Нейросеть, которая преобразует изображение напрямую в текстовую последовательность без явного этапа сегментации символов.
Такие системы обычно состоят из нескольких компонентов, работающих совместно:
- Сверточные сети (CNN) — извлекают визуальные признаки, такие как линии и формы;
- Рекуррентные сети (RNN) или трансформеры — анализируют последовательность символов с учётом контекста;
- Механизмы внимания (attention) — позволяют модели «фокусироваться» на нужных частях изображения.
Дополнительно используется языковая модель, которая помогает исправлять ошибки, опираясь на вероятности слов и грамматику. Это похоже на автокоррекцию: даже если часть букв распознана неверно, система может восстановить слово целиком.
Современные модели распознавания рукописного текста достигают точности более 90% на стандартизированных датасетах, однако в реальных условиях (например, школьные тетради) этот показатель заметно ниже.
Важную роль играет и обучение на разнообразных данных: чем больше примеров почерков видит модель, тем лучше она справляется с новыми вариантами. Однако полностью универсального решения пока не существует — слишком велико разнообразие человеческого письма.
Почему нейросети всё ещё ошибаются
Даже самые продвинутые модели ограничены качеством данных и вычислительными ресурсами. Они могут путать похожие слова, неправильно интерпретировать редкие сокращения или ошибаться в нестандартных записях, особенно без достаточного контекста.
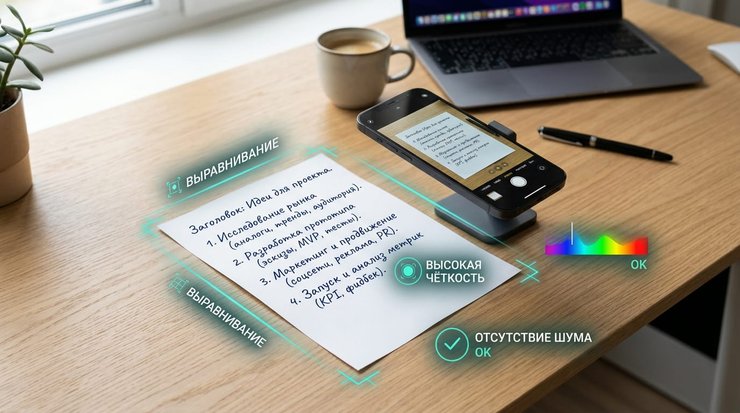
Практические советы для повышения точности распознавания
Хотя алгоритмы распознавания продолжают развиваться, итоговый результат во многом зависит от того, какое изображение подаётся на вход. Подготовка фото и аккуратность исходного текста могут значительно повысить точность даже без изменения самой технологии.
На практике это означает, что пользователь может напрямую влиять на качество распознавания, устраняя наиболее типичные источники ошибок.
- Снимайте при хорошем освещении — избегайте теней, бликов и жёлтого света ламп.
- Держите камеру ровно — текст должен быть без наклона и перспективных искажений.
- Используйте высокое разрешение — мелкие детали букв должны быть чётко видны.
- Избегайте размытия — зафиксируйте телефон или делайте несколько снимков.
- Очищайте фон — уберите лишние объекты и посторонние надписи.
Не менее важно и качество самого рукописного текста. Даже простые изменения могут облегчить задачу алгоритму:
- пишите разборчиво и с равномерным интервалом между словами;
- по возможности избегайте сильных сокращений;
- не накладывайте исправления поверх текста;
- используйте контрастную ручку (тёмный текст на светлой бумаге).
С технической точки зрения это снижает влияние шума и искажений, позволяя модели сосредоточиться на распознавании самих символов, а не на «очистке» изображения.
Практика показывает, что улучшение условий съёмки может повысить точность распознавания на 15–30% без каких-либо изменений в алгоритмах.
Когда даже идеальное фото не помогает
Если почерк слишком неразборчивый или содержит нестандартные обозначения, алгоритм может ошибаться независимо от качества изображения. В таких случаях ограничения связаны уже не с фото, а с природой самого рукописного текста.
Почему рукописный текст остаётся вызовом
Распознавание рукописного текста — это задача, где сталкиваются вариативность человеческого письма, ограничения алгоритмов и качество исходных данных. В отличие от печатного текста с его предсказуемой структурой, почерк создаёт множество неоднозначностей: от формы букв до их границ и расположения на странице. Современные нейросети уже умеют учитывать контекст и работать со сложными случаями, но полностью устранить ошибки пока невозможно. Именно поэтому итоговый результат всегда зависит не только от технологии, но и от того, насколько аккуратно написан текст и насколько качественно сделано фото.
Если вы хотите получать более точные результаты, начните с простого: улучшите условия съёмки и подачу текста — это даёт заметный эффект без сложных инструментов.
Редакция LifeGlobe.netПросмотров: 77
Материалы по теме
 Почему ИИ не станет разумным, как человек
 Самая тихая комната на планете в Building 87
 Ветряная мельница Болле с двойным ротором
 К 2030 году ИИ выпьет больше воды, чем всё человечество
 Птичье гнездо — Национальный стадион Пекина
 Штаб-квартира CCTV в Пекине — здание-петля Рема Колхаса
 Capital Gate в Абу-Даби: башня с наклоном 18 градусов
 Часовая башня Абрадж аль-Баит в Мекке: 601 метр над святыней
 Lotte World Tower: 555 метров над Сеулом
 Merdeka 118 — второе по высоте здание в мире

